计算医学综合解决方案——驱动精准科研与临床转化
随着高通量测序技术、医学大数据、人工智能和计算能力的快速发展,医学研究正在从传统经验驱动逐步迈向数据驱动与模型驱动的新阶段。“计算医学(Computational Medicine)”作为交叉前沿领域,融合了生物信息学、医学统计学、流行病学、系统生物学、多模态数据分析及人工智能技术,在疾病机制研究、临床决策支持、新药研发和公共卫生管理中发挥着越来越重要的作用。
依托公司在科研服务领域的经验积累,整合多学科计算方法,构建覆盖基础研究-临床研究-转化医学-公共卫生全链条的《计算医学综合解决方案》,为高校、医院、科研院所、生物医药企业提供系统化、模块化、可定制的一站式科研与转化服务。
一、核心业务模块
模块一:生物信息学与多组学整合分析
定位:疾病分子机制解析与生物标志物发现
1) RNA-seq、WES/WGS、单细胞、空间转录组分析
2) 蛋白质组、代谢组及多组学联合分析
3) 差异分析、通路富集、网络分析、免疫微环境分析
4) 公共数据库挖掘(TCGA、GEO、ICGC等)
数据深度挖掘:利用机器学习与统计模型,从海量公共数据库(如TCGA、GEO、ICGC)或私有数据中筛选关键生物标志物、构建分子分型、解析致病通路。
多组学数据整合:突破单一组学局限,通过多层次数据融合技术,系统阐明疾病发生发展的分子网络机制。
课题设计与基金支持:结合热点领域与客户方向,提供创新性课题设计、生信故事线构建及基金申请所需的前期数据支撑。
成本与效率优势:基于开源数据与可重复分析流程,大幅降低实验成本与时间,快速产生可发表级结果,尤其适合经费有限或需快速启动的课题组。
案例一:单细胞+空转+百种机器学习
题目:空间重编程衍生的GPNMB+巨噬细胞与COL6A3+成纤维细胞相互作用,增强GBM血管纤维化
文章聚焦胶质母细胞瘤(GBM)新辅助联合治疗(PD-1抑制剂+酪氨酸激酶抑制剂)耐药的核心机制,选题直击临床痛点——这类联合疗法在其他癌症中疗效显著,但在GBM中收效甚微,研究价值突出且极具挑战性。
实验层面不仅涉及原代细胞分离、类器官培养等复杂操作,还通过原子力显微镜等技术解析血管纤维化,技术门槛不低。而文章创新性锁定COL6A3 +肿瘤相关成纤维细胞(TAFs)与GPNMB+单核细胞衍生巨噬细胞(MDMs)的互作环路,这两种细胞亚群既是肿瘤微环境研究的核心靶点,也是国自然申报的热门方向,精准踩中研究前沿。
研究思路上,“单细胞测序+空间转录组+机器学习建模” 的三重组合堪称高分标配,更难得的是作者整合GEO、TCGA 等公共数据集,无需额外开展大规模测序,这种 “数据挖掘 + 实验验证” 的高效思路,既降低了研究成本,又保证了结果的可靠性和泛化性,实用性拉满~
核心目标:解析GBM 患者对免疫检查点阻断(ICB)联合抗血管生成治疗耐药的分子机制,挖掘关键细胞亚群及相互作用,提出潜在治疗策略。
研究对象:整合61例胶质瘤患者样本(含新诊断 GBM、低级别胶质瘤、复发 GBM、新辅助治疗应答者/无应答者),结合公共数据库(TCGA、CGGA 等)的批量测序和空间转录组数据。
分组设置:按治疗应答状态分为新辅助治疗应答组(7例)和无应答组(5例),按肿瘤类型、分子特征(IDH 突变、MGMT启动子甲基化)等进行分层分析。
核心假设:肿瘤微环境(TME)中基质细胞与巨噬细胞的相互作用调控血管纤维化和免疫排斥,是治疗耐药的关键。
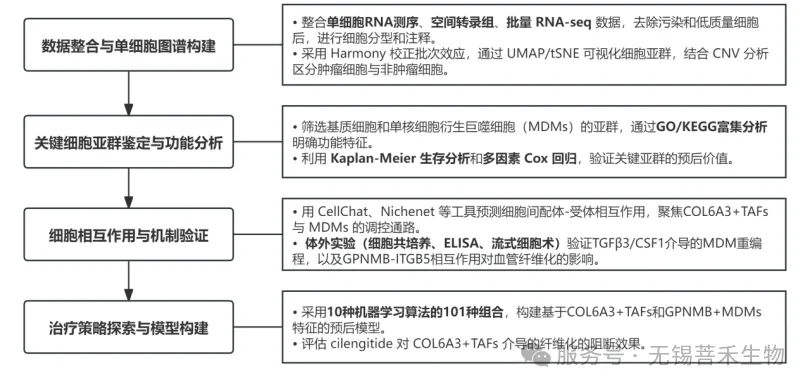
总体技术路线:
案例二:多组学筛选标志物+机器学习+SHAP构建预测模型
题目:多组整合揭示了乳腺癌新辅助治疗反应的亚型特异性预测因子
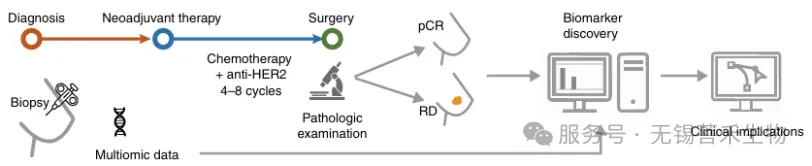
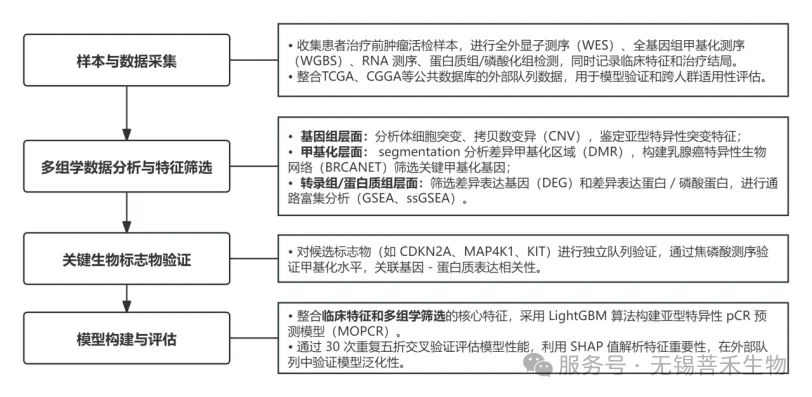
文章聚焦乳腺癌新辅助治疗病理完全缓解(pCR)的亚型特异性预测,选题直击临床痛点——不同分子亚型患者治疗应答差异巨大,精准预测pCR对优化治疗方案、避免无效治疗至关重要,研究价值突出且实用性强。基于筛选的亚型特异性标志物构建机器学习预测模型,虽然工作量大但是思路比较容易理解和模仿。
实验层面不仅开展了149例中国患者的多组学profiling(涵盖基因组、甲基化组、转录组、蛋白质组/磷酸化组),还通过焦磷酸测序、独立队列验证等完善证据链,多平台数据整合的技术门槛不低。而文章创新性锁定亚型特异性甲基化标志物(ER⁻HER2⁻亚型 CDKN2A、ER⁺HER2⁺亚型 MAP4K1 等),这些分子既是表观遗传学研究的核心靶点,也是国自然表观调控方向的热门方向,精准契合研究前沿。
研究思路上,“多组学整合+亚型特异性机器学习建模” 的组合堪称高分论文标配,更难得的是作者聚焦中国人群特征,弥补了西方人群模型在东亚患者中的适用性短板,还开发了可直接访问的在线预测工具(MOPCR),这种 “基础研究+ 临床转化 + 工具化落地” 的闭环思路,既保证了研究的深度,又提升了临床应用价值。
核心目标:揭示不同分子亚型乳腺癌患者对新辅助治疗(NACT)应答的多组学特征,开发精准预测病理完全缓解(pCR)的亚型特异性模型,为个体化治疗提供依据。
研究对象:149例中国乳腺癌患者,按ER/HER2状态分为ER⁺HER2⁺(55 例)、ER⁻HER2⁺(42 例)、ER⁻HER2⁻(52 例)三个亚型,根据治疗结局分为pCR组(81 例)和残留病灶(RD)组(68 例),同时整合多个独立外部队列(TransNEO、BrightNess 等)进行验证。
分组依据:以术后病理结果为金标准,pCR定义为乳腺及腋窝淋巴结无残留癌细胞,RD进一步分为RCB I-III 级;结合临床特征(肿瘤大小、淋巴结转移、Ki67指数等)和多组学数据进行分层分析。
核心假设:不同亚型乳腺癌的治疗应答受特异性分子特征调控,整合多组学数据和临床信息可提升pCR预测准确性,且中国人群存在独特分子特征。
模块二:医学统计与数据库分析解决方案
定位:临床问题的数据驱动回答
1) NHANES、SEER、UK Biobank、MIMIC 等数据库分析
2) 横断面研究、队列研究、病例对照研究设计
3) 生存分析、回归模型、倾向性评分匹配(PSM)
4) 机器学习/预测模型构建
高分文章导向分析:针对不同临床科室的科研需求,设计队列研究、诊断预测模型、生存分析等方案,助力发表3-10+分SCI论文。
高级统计与机器学习应用:超越传统统计,应用LASSO、随机森林、神经网络等算法提升模型性能与文章创新性。